
איך מבטיחים שמרכז נתונים ימשיך לפעול גם בזמן חירום?
רציפות תפקודית במרכז נתונים מבוססת על כך שכשל במערכת אחת לא ישבית את השירות כולו. לשם כך מתכננים יתירות של חשמל, קירור, תקשורת ומערכות קריטיות, לצד גיבוי נתונים ואתרים חלופיים. תוכניות BCP ו־DR מגדירות כיצד הארגון ממשיך לפעול וכיצד משחזרים מערכות לאחר אירוע. יעדי RTO ו־RPO קובעים כמה מהר יש להחזיר שירות וכמה מידע ניתן להרשות לעצמנו לאבד. המפתח הוא לא רק התכנון – אלא גם בדיקות ותרגול של התרחישים.
כיצד ממשיכים לספק שירות גם כאשר אתר, מערכת או תשתית קריטית יוצאים מכלל פעולה?
מרכז נתונים נבחן לא רק ביכולתו לפעול בשגרה, אלא בעיקר ביכולתו להמשיך לספק שירות כאשר מתרחשת תקלה חמורה: הפסקת חשמל ממושכת, כשל במערכת הקירור, שריפה, הצפה, מתקפת סייבר, ניתוק תקשורת, תקלה אנושית או אירוע אזורי המשבית את האתר כולו.
יתירות של UPS, גנרטורים, משאבות וקווי תקשורת היא תנאי בסיסי לשרידות, אך היא אינה מבטיחה לבדה רציפות תפקודית. מתקן יכול לכלול מערכות בתצורת N+1 או 2N, ועדיין לסבול מהשבתה אם קיימת נקודת כשל משותפת, אם תוכנית ההתאוששות אינה מעודכנת, אם הנתונים אינם ניתנים לשחזור או אם צוותי התפעול אינם יודעים כיצד לפעול בזמן אמת.
רציפות תפקודית דורשת חיבור בין ארבע שכבות:
- התשתית הפיזית של מרכז הנתונים.
- מערכות המחשוב, התקשורת והאחסון.
- הנהלים הארגוניים ותהליכי קבלת ההחלטות.
- האנשים שנדרשים להפעיל את התוכנית בעת משבר.
תקן ISO 22301 מגדיר מסגרת לניהול רציפות עסקית, שנועדה לסייע לארגונים להתכונן לשיבושים, להמשיך לספק מוצרים ושירותים ברמה שנקבעה מראש ולהתאושש מאירועים משביתים. המהדורה התקפה היא ISO 22301:2019, בצירוף תיקון משנת 2024, ובשנת 2026 כבר מצויה מהדורה חדשה בתהליך פיתוח. (ISO)
רציפות תפקודית אינה רק גיבוי נתונים
אחת הטעויות הנפוצות היא לזהות התאוששות מאסון עם גיבוי בלבד. גיבוי הוא רכיב חשוב, אך הוא אינו תוכנית התאוששות מלאה.
ארגון יכול להחזיק עותקים של כל המידע שלו, אך עדיין לא להיות מסוגל להחזיר את השירות לפעילות אם:
- אין תשתית חלופית שעליה ניתן להפעיל את המערכות.
- אין גישה למפתחות הצפנה או לחשבונות הניהול.
- הגיבוי אינו תואם לגרסת התוכנה הפעילה.
- לא הוגדר סדר ההפעלה של המערכות.
- התקשורת אל האתר החלופי אינה זמינה.
- שירותי זהות, DNS או אבטחה אינם מתאוששים.
- אנשי המפתח אינם זמינים.
- מעולם לא בוצעה בדיקת שחזור מלאה.
לכן יש להבחין בין כמה מושגים משלימים.
Business Continuity – רציפות עסקית
רציפות עסקית עוסקת ביכולת הארגון להמשיך לספק שירותים חיוניים ברמה מוסכמת גם בזמן שיבוש.
היא כוללת לא רק את מערכות ה־IT, אלא גם כוח אדם, ספקים, אתרים, תקשורת, נהלים, תהליכים עסקיים וקבלת החלטות.
Disaster Recovery – התאוששות מאסון
התאוששות מאסון מתמקדת בהחזרת מערכות המחשוב, הנתונים והתשתיות הטכנולוגיות לפעולה לאחר אירוע משבית.
תוכנית DR צריכה להגדיר:
- אילו מערכות משוחזרות.
- באיזה סדר הן משוחזרות.
- היכן הן מופעלות.
- מאיזה עותק מידע.
- מי מוסמך להכריז על מעבר לאתר חלופי.
- כיצד חוזרים לאחר מכן לאתר הראשי.
Incident Response – תגובה לאירוע
תגובה לאירוע מתמקדת בזיהוי האירוע, הכלתו, חקירתו והפחתת הנזק המיידי.
לדוגמה, בעת מתקפת סייבר ייתכן שצוות התגובה ינתק מערכות מהרשת כדי למנוע התפשטות, בעוד צוות ההתאוששות יפעל להקמת סביבה נקייה ולהחזרת השירות.
Crisis Management – ניהול משבר
ניהול המשבר עוסק בקבלת החלטות ברמת ההנהלה, תקשורת עם לקוחות ורשויות, תיאום בין בעלי תפקידים וניהול ההשלכות העסקיות והציבוריות.
העיקרון המרכזי: תגובה לאירוע עוצרת את ההידרדרות; התאוששות מאסון מחזירה את הטכנולוגיה; רציפות עסקית שומרת על השירות; וניהול המשבר מכוון את הארגון כולו.
BIA – הבסיס לכל תוכנית רציפות
לפני שבוחרים אתר גיבוי או טכנולוגיית שכפול, יש לבצע Business Impact Analysis – ניתוח השפעה עסקית.
מטרת ה־BIA היא לזהות אילו שירותים ותהליכים חיוניים לארגון, מהי השפעת השבתתם וכמה זמן ניתן להמשיך בלעדיהם.
NIST מציב את ה־BIA כאחד השלבים המרכזיים בתהליך תכנון ההמשכיות, לצד זיהוי אמצעי מניעה, גיבוש אסטרטגיות התאוששות, כתיבת התוכנית, ביצוע הדרכות ותרגילים ותחזוקת התוכנית לאורך זמן. (csrc.nist.gov)
הניתוח צריך לבחון:
- אילו שירותים חייבים להמשיך לפעול.
- אילו מערכות תומכות בכל שירות.
- אילו נתונים נדרשים להפעלתו.
- באילו ספקים ותשתיות הוא תלוי.
- מהי ההשפעה הכספית של ההשבתה.
- מהי ההשפעה על בטיחות, רגולציה ומוניטין.
- כמה זמן ניתן להפעיל תהליך חלופי או ידני.
- אילו מערכות ניתן לשחזר בשלב מאוחר יותר.
התוצאה אינה רשימה כללית של “מערכות קריטיות”, אלא מפת תלות מלאה.
לדוגמה, מערכת עסקית עשויה להיות זמינה באתר החלופי, אך לא לתפקד משום שמערכת אימות הזהויות, בסיס הנתונים, שירות ה־DNS או קישור התקשורת לא שוחזרו.
ארבעת מדדי הזמן והמידע שחייבים להגדיר
RTO – Recovery Time Objective
RTO הוא משך הזמן המרבי שנקבע להחזרת שירות או מערכת לפעילות לאחר השבתה.
לדוגמה:
- מערכת חיונית: RTO של 15 דקות.
- מערכת תפעולית חשובה: RTO של שעתיים.
- מערכת מנהלית: RTO של 24 שעות.
RTO אינו הזמן שהארגון “מקווה” להשיג. זהו יעד שצריך להיות מגובה בתכנון, בציוד, בכוח אדם, בחוזים ובבדיקות.
ככל שה־RTO קצר יותר, נדרשת בדרך כלל תשתית יקרה ומורכבת יותר.
RPO – Recovery Point Objective
RPO מגדיר את כמות המידע המרבית שהארגון מוכן לאבד, במונחי זמן.
אם RPO הוא 15 דקות, הארגון צריך להיות מסוגל לשחזר את הנתונים לנקודה שאינה ישנה ביותר מ־15 דקות לפני האירוע.
RPO קרוב לאפס מחייב בדרך כלל שכפול רציף או כמעט רציף. עם זאת, שכפול מיידי עלול להעביר גם מחיקות, הצפנות זדוניות או שיבוש נתונים אל האתר החלופי. לכן נדרשים גם עותקים היסטוריים שאינם משתנים.
MTPD – Maximum Tolerable Period of Disruption
זהו פרק הזמן המרבי שבו ניתן לסבול את הפסקת הפעילות לפני שהנזק לארגון הופך לבלתי מתקבל.
ה־RTO צריך להיות קצר מה־MTPD ולהותיר זמן לחזרת הפעילות העסקית המלאה, לבדיקות ולאימות הנתונים.
WRT – Work Recovery Time
גם לאחר שהמערכת הטכנולוגית חזרה לפעול, נדרש זמן נוסף להשלמת עבודות, סנכרון נתונים, בדיקות וחזרת המשתמשים לעבודה מלאה.
אפשר להציג את הקשר כך:
אירוע משבית ← שחזור טכנולוגי לפי RTO ← חזרת תהליכי העבודה לפי WRT ← לפני חציית ה־MTPD
טעות נפוצה: לקבוע RTO ו־RPO אחידים לכל המערכות. יעדים שונים צריכים להיקבע לפי החשיבות העסקית, התלות בין המערכות והעלות של ההשבתה.
זמינות גבוהה אינה התאוששות מאסון
High Availability נועדה לשמור על זמינות השירות בעת כשל נקודתי.
Disaster Recovery נועד להתמודד עם אירוע רחב יותר, שבו המערכת, האולם או האתר כולו אינם זמינים.
דוגמאות לזמינות גבוהה:
- שני ספקי כוח בשרת.
- אשכול שרתים.
- יחידת UPS נוספת.
- קישור תקשורת כפול.
- מערך אחסון עם שכפול פנימי.
- משאבה בתצורת N+1.
דוגמאות להתאוששות מאסון:
- מעבר למרכז נתונים חלופי.
- הפעלת מערכות באזור גאוגרפי אחר.
- שחזור נתונים מעותק בלתי תלוי.
- ניתוב משתמשים לסביבה חלופית.
- הפעלת תהליכים עסקיים מאתר חירום.
מערכת יכולה להיות בעלת זמינות גבוהה ועדיין להיות חשופה לכשל כולל אם כל רכיביה נמצאים באותו אתר, תלויים באותו ספק חשמל או מחוברים דרך אותו נתיב תקשורת.
נקודת הכשל המשותפת – האויב הסמוי של היתירות
יתירות אמיתית אינה נמדדת במספר הרכיבים, אלא במידת העצמאות ביניהם.
שתי מערכות אינן באמת יתירות אם הן חולקות:
- אותו חדר חשמל.
- אותו שנאי.
- אותו לוח בקרה.
- אותו Busway.
- אותו פיר כבלים.
- אותה צנרת מים.
- אותה מערכת BMS.
- אותו ספק תקשורת ונתיב פיזי.
- אותו מקור דלק.
- אותה מערכת זהויות.
- אותו חשבון ניהול.
- אותו אתר גאוגרפי.
- אותו צוות יחיד שאינו זמין בחירום.
לדוגמה, שני קווי סיבים מספקים שונים אינם מספקים שרידות אם שניהם עוברים באותה תעלה ונפגעים באותה עבודת חפירה.
באופן דומה, שני אולמות שרתים אינם מייצרים הפרדה מספקת אם הם תלויים באותה מערכת קירור מרכזית ללא חציצה.
לכן ניתוח הרציפות צריך להתמקד לא רק ברכיבים אלא גם ב־Common Mode Failure – כשל משותף המשבית כמה שכבות במקביל.
אתר חלופי – לא כל מרחק יוצר שרידות
בחירת אתר התאוששות דורשת איזון בין מרחק, Latency, תקשורת, עלויות ותלות גאוגרפית.
אתר חלופי קרוב מאפשר בדרך כלל:
- תקשורת מהירה יותר.
- Latency נמוך.
- שכפול סינכרוני.
- גישה נוחה של צוותים.
- פשטות תפעולית.
עם זאת, הוא עלול להיפגע מאותו אירוע אזורי:
- הפסקת חשמל רחבה.
- כשל ברשת תקשורת אזורית.
- מזג אוויר קיצוני.
- הצפה.
- רעידת אדמה.
- חסימת דרכי גישה.
- אירוע ביטחוני.
- תקלה בתשתית ארצית משותפת.
אתר רחוק יותר מספק עצמאות גאוגרפית טובה יותר, אך עשוי להגדיל את זמן התגובה, את ה־Latency ואת עלויות התקשורת.
אין מרחק אוניברסלי שנחשב “נכון”. המרחק צריך להיקבע על בסיס ניתוח הסיכונים, דרישות השכפול והאירועים שהארגון מבקש לשרוד.
מודלים של אתרי התאוששות
Cold Site – אתר קר
אתר בעל תשתית בסיסית, אך ללא מערכות מחשוב פעילות ומוכנות.
יתרונות:
- עלות נמוכה יחסית.
- גמישות בבחירת הציוד.
- מתאים למערכות בעלות RTO ארוך.
חסרונות:
- זמן התאוששות ממושך.
- צורך בהתקנת ציוד ותוכנה.
- תלות בזמינות כוח אדם וספקים.
- קושי לעמוד ביעדי שחזור קצרים.
Warm Site – אתר חם חלקית
אתר הכולל תשתית וציוד מותקנים, אך אינו מחזיק בהכרח עותק מיידי ומלא של סביבת הייצור.
יתרונות:
- זמן התאוששות קצר יותר.
- עלות בינונית.
- מתאים למערכות שאינן מחייבות מעבר מיידי.
חסרונות:
- נדרש סנכרון והשלמת תצורה.
- קיים סיכון לפערי גרסאות.
- נדרשות בדיקות לפני פתיחת השירות.
Hot Site – אתר חם
אתר פעיל ומוכן, הכולל תשתיות, מערכות ושכפול מידע עדכני.
יתרונות:
- מעבר מהיר.
- יכולת לעמוד ב־RTO קצר.
- אפשרות לבדיקות סדירות.
חסרונות:
- עלות גבוהה.
- מורכבות תפעולית.
- צורך בשמירה רציפה על זהות התצורות.
- סיכון להפצת שיבוש או מתקפה בין האתרים.
Active-Passive
האתר הראשי מפעיל את השירות, והאתר החלופי ממתין להפעלה במקרה כשל.
מודל זה פשוט יחסית, אך מחייב בדיקות קבועות כדי לוודא שהאתר הפסיבי באמת מסוגל לקבל את העומס.
Active-Active
שני אתרים או יותר מספקים שירות בו־זמנית.
היתרונות הם ניצול משאבים, מעבר מהיר ופיזור עומסים. מנגד, המודל דורש תכנון מורכב של נתונים, עקביות, ניתוב, זהויות ומניעת מצב שבו שני אתרים מקבלים החלטות סותרות.
שכפול סינכרוני או א־סינכרוני?
שכפול סינכרוני
הפעולה נחשבת מושלמת רק לאחר שהמידע נכתב גם באתר הנוסף.
היתרון המרכזי הוא RPO קצר מאוד או קרוב לאפס.
החסרונות:
- רגישות ל־Latency.
- דרישות תקשורת גבוהות.
- השפעה אפשרית על ביצועי היישום.
- סיכון להעברת שיבוש לשני האתרים.
שכפול א־סינכרוני
המידע מועבר לאתר החלופי לאחר שנכתב באתר הראשי.
היתרונות:
- מתאים למרחקים גדולים יותר.
- תלות נמוכה יותר בזמני התקשורת.
- פגיעה קטנה יותר בביצועי היישום.
החיסרון המרכזי הוא פער נתונים אפשרי, בהתאם לקצב השכפול ולמצב הקישור בזמן האירוע.
הבחירה אינה צריכה להיעשות ברמת מרכז הנתונים כולו, אלא ברמת השירות או בסיס הנתונים. מערכות קריטיות עשויות לדרוש שכפול סינכרוני, בעוד מערכות אחרות יכולות להסתפק בשכפול תקופתי.
גיבוי עמיד בפני מתקפות סייבר
אסטרטגיית התאוששות מודרנית חייבת להניח שגם סביבת הייצור, חשבונות הניהול והעותקים המקוונים עלולים להיפגע.
לכן יש לשלב:
- עותקים מבודדים מהרשת.
- עותקים שאינם ניתנים לשינוי לתקופה מוגדרת.
- גרסאות היסטוריות.
- הפרדת הרשאות בין ייצור לגיבוי.
- אימות רב־שלבי.
- מפתחות הצפנה המאוחסנים בנפרד.
- בדיקות תקינות אוטומטיות.
- סריקת העותק לפני שחזור.
- סביבת התאוששות נקייה.
שכפול אינו גיבוי. אם מידע מוצפן, נמחק או נפגם באתר הראשי, השכפול עלול להעביר את אותו נזק לאתר המשני.
תוכנית התאוששות צריכה לאפשר לבחור נקודת שחזור קודמת, לוודא שהיא נקייה ולהפעיל את המערכות בסביבה מבודדת לפני חיבורן מחדש לרשת הייצור.
סדר ההתאוששות – לא מפעילים הכול במקביל
תהליך ההתאוששות חייב לפעול לפי Runbook מסודר.
סדר אופייני עשוי להיות:
- אימות בטיחות האתר והציוד.
- הקמת תקשורת וניהול מאובטח.
- הפעלת שירותי זהות והרשאות.
- הפעלת DNS, זמן, תעודות ושירותי תשתית.
- החזרת מערכות אחסון ובסיסי נתונים.
- הפעלת שכבת היישומים.
- פתיחת ממשקים למערכות חיצוניות.
- ביצוע בדיקות תקינות.
- פתיחת השירות למשתמשים באופן מדורג.
- ניטור מוגבר לאחר החזרה.
הסדר צריך לשקף את התלויות האמיתיות בין המערכות. הפעלת יישום לפני מסד הנתונים, שירות הזהויות או מערכות האבטחה עלולה להאריך את האירוע ואף ליצור נזק נוסף.
הכרזה על אסון – מי מקבל את ההחלטה?
אחת ההחלטות הקשות היא מתי להפסיק לנסות לתקן את האתר הראשי ולעבור לסביבת ההתאוששות.
מעבר מוקדם מדי עלול לגרום להשבתה מיותרת ולסיכון נתונים. מעבר מאוחר מדי עלול לגרום להחמצת ה־RTO.
יש להגדיר מראש תנאי הפעלה, למשל:
- אובדן האתר לזמן העולה על סף מוגדר.
- כשל בו־זמני בכמה שכבות תשתית.
- חוסר יכולת להעריך את זמן התיקון.
- פגיעה בשלמות הנתונים.
- אירוע סייבר המחייב בידוד מלא.
- פינוי האתר.
- חוסר יכולת להבטיח בטיחות לצוותים.
- החלטת הנהלת המשבר.
הסמכות להכריז על מעבר צריכה להיות ברורה, לרבות מחליפים במקרה שבעל התפקיד הראשי אינו זמין.
Failover אינו סוף התהליך
לאחר המעבר לאתר החלופי, נדרש לוודא שכל השירותים פועלים, שהנתונים עקביים, שהמשתמשים מנותבים ליעד הנכון, שמערכות האבטחה והניטור פעילות ושהאתר החלופי מסוגל לשאת את מלוא העומס לאורך התקופה הנדרשת.
לאחר תיקון האתר הראשי מגיע שלב ה־Failback – החזרת השירותים והעומסים מסביבת ההתאוששות אל סביבת הייצור המקורית. שלב זה עלול להיות מורכב ואף ממושך יותר מתהליך ה־Failover עצמו, בעיקר כאשר במהלך תקופת החירום הצטברו באתר החלופי כמויות גדולות של נתונים חדשים, בוצעו שינויים במערכות או נוצרו פערים בין שתי הסביבות.
משך ה־Failback תלוי, בין היתר, בנפח הנתונים שיש לסנכרן, בקצב קווי התקשורת, במורכבות בסיסי הנתונים, במספר המערכות התלויות זו בזו וביכולת לבצע את המעבר בלי לפגוע בשירות הפעיל. במערכות עמוסות, תהליך ההעתקה, האימות והסנכרון עלול להימשך שעות ואף יותר מהזמן שתוכנן במקור.
אין לבצע חזרה אוטומטית רק משום שהאתר הראשי חזר לפעילות. תחילה יש לוודא שהוא יציב ובטוח, לבדוק את תשתיות החשמל, הקירור והתקשורת, לסנכרן את הנתונים, לבצע בדיקות תקינות ולבנות תוכנית מעבר מפורטת.
במקרים מסוימים נכון להמשיך לפעול מהאתר החלופי גם לאחר תיקון האתר הראשי, עד להשלמת הסנכרון ולבחירת חלון תחזוקה שבו ניתן לבצע את החזרה באופן מדורג ומבוקר.
העיקרון התפעולי: זמן ההתאוששות אינו מסתיים עם הפעלת האתר החלופי. יש לתכנן ולמדוד גם את זמן החזרה הבטוחה לאתר הראשי, לרבות סנכרון הנתונים, בדיקות התקינות והחזרת היתירות.
רציפות התשתיות הפיזיות
תוכנית DR של מערכות IT אינה מספיקה אם האתר החלופי אינו מסוגל לתמוך בעומס.
יש לוודא:
- קיבולת חשמלית מספקת.
- קיבולת UPS וגנרטורים.
- אספקת דלק.
- קיבולת קירור.
- תמיכה בצפיפות ההספק הנדרשת.
- יכולת קירור נוזלי, אם נדרש.
- קווי תקשורת מתאימים.
- מלאי חלפים.
- כוח אדם.
- אבטחה פיזית.
- תנאי כניסה ותחזוקה.
- חוזים עם ספקים.
אתר חלופי שתוכנן לעומסי IT מסורתיים לא בהכרח יוכל לקלוט עומסי AI עתירי הספק וחום.
לכן תוכנית ההתאוששות חייבת להתעדכן יחד עם התפתחות החומרה ולא להישאר מבוססת על הנחות היסטוריות.
התלות בספקים ובענן
מרכזי נתונים וארגונים נשענים על ספקי חשמל, תקשורת, ענן, תוכנה, דלק, קירור, אבטחה ותחזוקה.
כל ספק מהווה חלק משרשרת הרציפות.
יש לבדוק:
- מהו ה־SLA של הספק.
- האם יש לו תוכנית רציפות.
- היכן נמצאים אתרי הגיבוי שלו.
- האם הוא תלוי באותו אזור או ספק משנה.
- מהם זמני התגובה בפועל.
- האם קיימת קדימות בחירום.
- האם קיימת חלופה.
- כיצד ניתן לייצא נתונים.
- כיצד ניתן לעבור לספק אחר.
- מי מחזיק במפתחות ובחשבונות הניהול.
שימוש בכמה ספקי ענן אינו בהכרח Multi-Cloud עמיד. אם כל המערכות תלויות באותה מערכת זהויות, באותה רשת או באותו צוות ניהול, נקודת הכשל המשותפת עדיין קיימת.
תקשורת בזמן משבר
בזמן אירוע, גם מערכות התקשורת הרגילות עלולות להיפגע.
לכן יש להכין מראש:
- רשימת אנשי קשר מעודכנת.
- ערוץ תקשורת חלופי.
- חדר מצב פיזי או וירטואלי.
- שיטת אימות זהות.
- תבניות דיווח.
- לוח זמנים לעדכונים.
- אנשי קשר אצל ספקים.
- גורם מוסמך לתקשורת חיצונית.
- מנגנון לתיעוד החלטות.
אין להסתמך רק על דואר אלקטרוני ארגוני, Teams או מערכת אחת שעלולה להיות חלק מהאירוע.
בזמן משבר, מידע חלקי עדיף על שתיקה – אך מידע לא מאומת עלול להחמיר את האירוע.
בדיקות ותרגילים – תוכנית שלא נבדקה אינה תוכנית
NIST מדגיש כי תכנון המשכיות צריך לכלול בדיקות, הדרכות ותרגילים, ולא להסתיים בכתיבת מסמך. (csrc.nist.gov)
יש לבצע כמה סוגי תרגילים.
Tabletop Exercise – תרגיל שולחני
הצוותים עוברים על תרחיש ומקבלים החלטות ללא שינוי במערכות הייצור.
התרגיל בוחן:
- תפקידים וסמכויות.
- תהליך ההכרזה.
- תקשורת.
- סדר פעולות.
- פערים בתוכנית.
- תלות בגורם יחיד.
Technical Recovery Test – בדיקת שחזור טכנית
שחזור מערכת, בסיס נתונים או שירות בסביבה מבודדת.
פרסום
הבדיקה צריכה לאמת לא רק שהקבצים קיימים, אלא שהיישום פועל ושהנתונים תקינים.
Failover Test – בדיקת מעבר
מעבר מתוכנן לאתר או למערכת החלופית.
יש למדוד:
- זמן מעבר בפועל.
- אובדן נתונים.
- סדר הפעלת המערכות.
- קיבולת האתר החלופי.
- תפקוד הממשקים.
- יכולת המשתמשים לעבוד.
Full-Scale Exercise – תרגיל מלא
תרגיל המדמה אירוע מקצה לקצה, כולל צוותי תפעול, הנהלה, ספקים, תקשורת ולעיתים גם משתמשים.
תרגיל כזה מורכב יותר, אך הוא היחיד שיכול לחשוף כשלים הנוצרים במפגש בין הטכנולוגיה, הנהלים והאנשים.
מה חייבים למדוד בתרגיל?
- האם ה־RTO הושג?
- האם ה־RPO הושג?
- כמה זמן נמשך שלב קבלת ההחלטה?
- האם רשימות אנשי הקשר היו מעודכנות?
- האם האתר החלופי נשא את מלוא העומס?
- האם הנתונים היו עקביים?
- האם כל בעלי התפקידים ידעו מה לעשות?
- האם התגלו הרשאות חסרות?
- האם קיימות תלויות שלא תועדו?
- האם הלקוחות והספקים קיבלו עדכון?
- האם החזרה לאתר הראשי הצליחה?
- אילו פעולות תיקון נדרשות?
לאחר התרגיל יש להפיק After Action Report, להגדיר פעולות מתקנות, בעלי אחריות ותאריכי יעד.
Management of Change – תוכנית ההתאוששות חייבת להשתנות עם המתקן
כל שינוי במערכת הייצור עלול להשפיע על יכולת ההתאוששות:
- התקנת שרת חדש.
- החלפת גרסת תוכנה.
- שינוי כתובת רשת.
- הוספת בסיס נתונים.
- שינוי במערכת הזהויות.
- הוספת ארון AI.
- שינוי במסלול החשמל.
- החלפת ספק תקשורת.
- שינוי בהצפנה.
- מעבר לשירות ענן.
- שינוי בתהליכים העסקיים.
לכן כל תהליך שינוי חייב לבדוק:
- האם המערכת נכללת בתוכנית ההתאוששות?
- האם הגיבוי שלה עודכן?
- האם האתר החלופי תומך בגרסה החדשה?
- האם ה־Runbook עודכן?
- האם נדרש תרגיל חדש?
- האם יעדי ה־RTO וה־RPO עדיין ניתנים להשגה?
תוכנית שאינה מתעדכנת הופכת בתוך זמן קצר למסמך שאינו משקף את המציאות.
תרחיש לדוגמה – אובדן מרכז הנתונים הראשי
שלב 1: זיהוי והכלה
מערכות הניטור מזהות אובדן של כמה תשתיות במקביל. צוות התפעול בודק אם מדובר בתקלה נקודתית או באירוע רחב.
במקביל נבדקים:
- מצב החשמל.
- מצב הקירור.
- תקשורת.
- בטיחות האש.
- שלמות הנתונים.
- זמינות הצוותים.
- זמן תיקון משוער.
שלב 2: הפעלת צוות המשבר
נפתח חדר מצב, בעלי התפקידים מוזעקים ומתחיל תיעוד רציף של האירוע.
הצוות מחליט אם ניתן להמשיך לפעול באתר או שיש להכריז על אסון.
שלב 3: הכרזה והפעלת DR
הגורם המוסמך מאשר מעבר לאתר החלופי.
מופעל ה־Runbook, נבדקת נקודת השחזור המתאימה ומתחיל תהליך הפעלת שירותי התשתית.
שלב 4: שחזור לפי סדר התלויות
שירותי זהות, DNS, תקשורת, אחסון ובסיסי נתונים מוחזרים לפני שכבת היישומים.
כל מערכת נבדקת לפני מעבר לשלב הבא.
שלב 5: ניתוב המשתמשים
תעבורה מועברת בהדרגה לאתר החלופי. תחילה נפתחים השירותים הקריטיים, ולאחר מכן שירותים בדרגת עדיפות נמוכה יותר.
שלב 6: תפעול במצב חירום
הצוות עוקב אחר עומסי החשמל, הקירור, התקשורת והמערכות העסקיות באתר החלופי.
פעולות שאינן חיוניות עשויות להידחות כדי לשמור קיבולת לשירותים הקריטיים.
שלב 7: תיקון והכנת החזרה
לאחר שהאתר הראשי חוזר לכשירות, מתבצעות בדיקות, סנכרון נתונים ותכנון Failback.
שלב 8: חזרה מבוקרת ותחקור
המערכות מוחזרות באופן מדורג, ולאחר מכן מתבצע תחקיר מלא ועדכון תוכנית הרציפות.
טעויות שעולות מיליוני שקלים
הנחה שיתירות מקומית מספיקה
N+1 בתוך אתר אחד אינה מגינה מפני השבתת האתר כולו.
קביעת RTO ללא בדיקה
יעד של 15 דקות אינו אמיתי אם המעבר המהיר ביותר שנבדק נמשך שעתיים.
שכפול במקום גיבוי
שכפול מיידי עלול להעביר מחיקה, הצפנה או שיבוש אל האתר החלופי.
אתר גיבוי התלוי באותה תשתית
שני אתרים עלולים להיות תלויים באותו ספק חשמל, נתיב סיבים או מערכת זהויות.
תכנון לפי קיבולת שגרה בלבד
האתר החלופי חייב לתמוך בעומס בזמן מעבר מלא, לא רק בעומס בדיקה חלקי.
Runbook שאינו מעודכן
כתובת IP, סיסמה, גרסת תוכנה או שם שרת שגויים יכולים לעצור את תהליך ההתאוששות.
התעלמות מ־Failback
חזרה לאתר הראשי ללא סנכרון ובדיקות עלולה לגרום לאובדן נתונים נוסף.
תלות באדם אחד
אם רק אדם אחד יודע להפעיל את התוכנית, הארגון אינו מחזיק ביכולת התאוששות אמיתית.
בדיקת שחזור של קבצים בלבד
יש לבדוק את השירות העסקי המלא, לרבות תלויות, זהויות, תקשורת ואבטחה.
אי־תרגול ספקים
ספק שמופיע בתוכנית אך אינו משתתף בתרגילים עלול לא להיות זמין ברגע האמת.
פתיחת האתר החלופי לפני אימות סייבר
בסביבת מתקפה, מעבר מהיר מדי עלול להפעיל מחדש קוד זדוני או חשבונות שנפגעו.
הטיפ ההנדסי – לתכנן את תרחיש הכשל כבר בשלב ההקמה
רציפות תפקודית אינה שכבה שמוסיפים לאחר שמרכז הנתונים כבר פועל.
כבר בשלב התכנון יש לשאול:
- מה קורה אם האתר כולו מושבת?
- מה קורה אם שני מסלולי התקשורת נפגעים?
- מה קורה אם מערכת הניהול אינה זמינה?
- מה קורה אם האתר החלופי מקבל את מלוא העומס?
- כמה זמן ניתן לפעול על דלק?
- מי מקבל את ההחלטה לעבור?
- כיצד מאמתים שהנתונים נקיים?
- כיצד חוזרים לאתר הראשי?
- כיצד פועלים אם הצוות אינו יכול להגיע למתקן?
- אילו שירותים ניתן להפסיק כדי לשמור על השירותים החיוניים?
מערכת עמידה אינה מערכת שלעולם אינה נכשלת. היא מערכת שכשל בה אינו הופך לאובדן שליטה, אובדן מידע או השבתה ממושכת.
מבט קדימה
מרכזי נתונים בעידן ה־AI מתמודדים עם עומסים גדולים יותר, חומרה צפופה יותר ותלות הולכת וגוברת בתשתיות חשמל, קירור נוזלי ותקשורת עתירת קיבולת.
במקביל, ארגונים עוברים למבנים היברידיים המשלבים מרכזי נתונים פרטיים, מתקני Colocation ושירותי ענן.
בסביבה זו, תוכנית התאוששות אינה יכולה להתמקד באתר יחיד או בטכנולוגיה אחת. היא צריכה לנהל את השירות מקצה לקצה ולבחון את כל שרשרת התלות: התשתית הפיזית, הענן, ספקי התקשורת, הזהויות, הנתונים, התוכנה והאנשים.
הדור הבא של רציפות תפקודית ישלב יותר אוטומציה, Infrastructure as Code, בדיקות שחזור רציפות ומודלים דיגיטליים של תלות בין מערכות. אך גם מערכת אוטומטית לחלוטין אינה פוטרת את הארגון מהצורך להגדיר סמכויות, לבדוק תרחישים ולקבל החלטות אחראיות בזמן משבר.
בסופו של דבר, מטרתה של תוכנית הרציפות אינה להבטיח שלא יתרחשו תקלות. מטרתה להבטיח שגם כאשר הן מתרחשות, הארגון יודע מה קרה, מי מחליט, לאן עוברים, איזה מידע משוחזר ובתוך כמה זמן השירות חוזר לפעול.
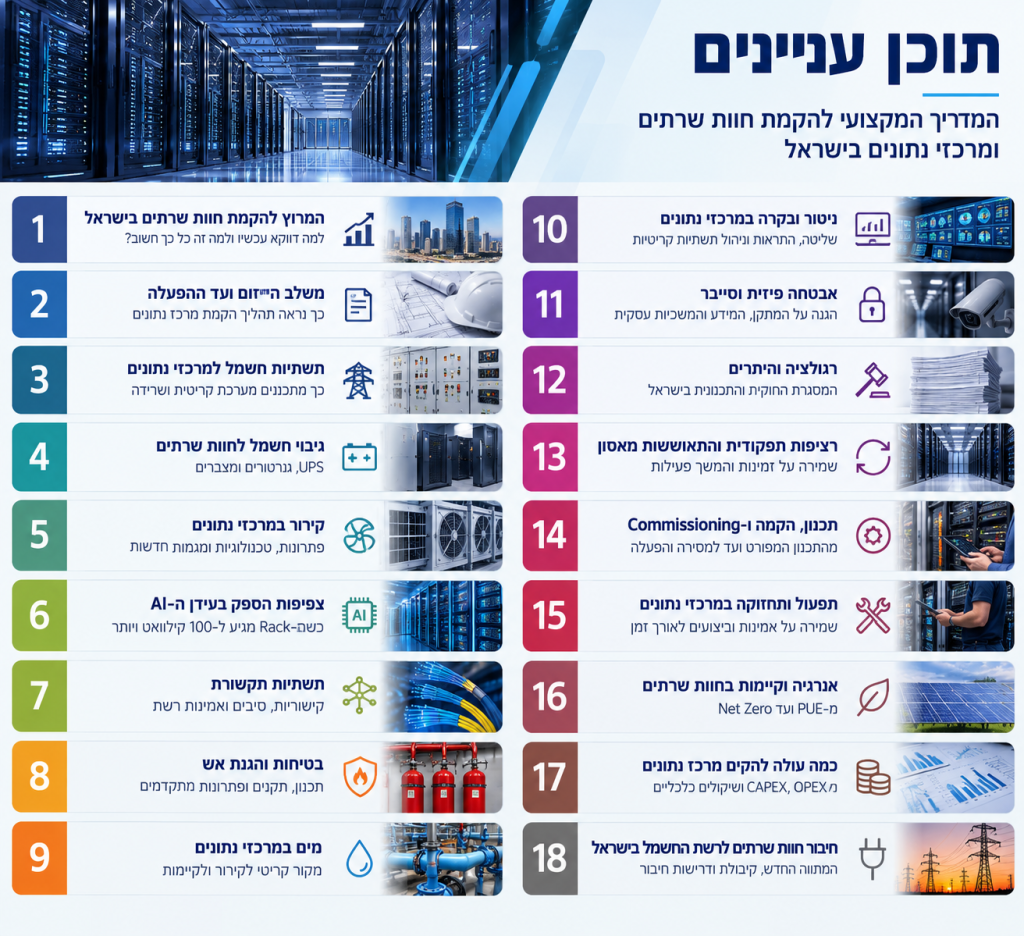
מאמר זה הוא חלק מהמדריך המקצועי להקמת מרכזי נתונים וחוות שרתים.
הבהרה משפטית: המידע במדריך נועד למידע מקצועי וכללי בלבד ואינו מהווה ייעוץ הנדסי, תכנוני, בטיחותי, משפטי או רגולטורי. האחריות לתכנון ולביצוע חלה על הגורמים המקצועיים ובהתאם לדין ולתקנים המחייבים. קבוצת פורטל נט אינה אחראית לנזק שייגרם מהסתמכות על התוכן.
© כל הזכויות שמורות לקבוצת פורטל נט.